AF分离论文串讲
来自一次由于某位太爱听分享导致的被迫营业…
Overview | 为什么需要AF分离
PD 分离解决的是 Prefill 和 Decode 之间的差异:Prefill 一次处理大量输入 token,通常更偏计算;Decode 每轮只生成一个 token,需要反复读取 KV cache,更受显存容量、带宽和 TPOT 约束。将两阶段分开后,可以分别配置并行策略、batch 和 GPU 数量。
但在大规模稀疏MoE模型中,仅仅分开 Prefill 和 Decode 仍然不够。即使只看 Decode,一个 Transformer 层内部仍然串联着两种需求明显不同的工作:
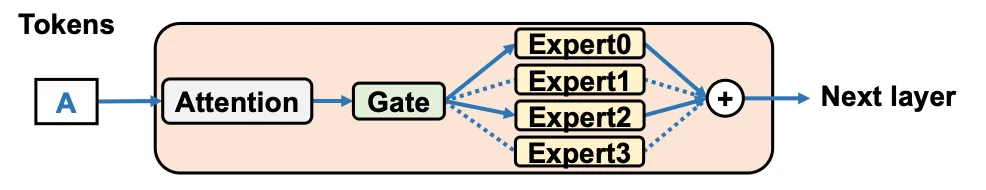
一个transformer layer 内部由attn和moe串接而成。
Attention和MoE表现出不同的负载特征,适宜的资源配置也不同:
| 维度 | Attention | MoE专家FFN |
|---|---|---|
| 主要数据 | 请求相关的 KV cache,以及 Attention 权重 | 专家权重 |
| 对上下文长度的依赖 | 常规全注意力下,KV 容量和读取量随上下文增长 | 基本没有,每 token 的专家计算量基本不随上下文增长 |
| 增大 batch 的作用 | 不同请求通常仍需读取各自的 KV,难以像权重那样跨请求复用 | 同一专家收到更多 token,可以复用权重,提高矩阵乘法效率 |
| 资源配置重点 | KV Cache 容量、带宽、上下文长度及延迟约束 | 每专家负载、权重容量、计算效率及路由通信 |
因此,同机部署形成了一个直接冲突:
- Attention:希望batch不要过大,以控制KV读取量和TPOT
- MoE FFN:希望汇聚更多token,以提高每专家batch和权重复用
而AF分离,则带来了4个潜在的优势:
- 独立调节batch。 Attention维持延迟友好的局部batch,FFN汇聚多个Attention实例的token。
- 独立选择并行策略。 Attention可侧重DP、TP或SP,FFN可采用更大的EP规模。
- 分离显存用途。 Attention GPU主要留给动态增长的KV cache,FFN GPU主要保存静态专家权重。
- 形成跨微批流水线。 当Attention处理一个微批时,FFN可以处理另一个微批,减少两类资源交替空闲。
基础|MegaScale-Infer(SIGCOMM 2025)
| ByteDance Seed & 北京大学 2025年7月 | https://arxiv.org/abs/2504.02263 |
Motivation:MoE 减少了计算量,却未必提高 GPU 利用率
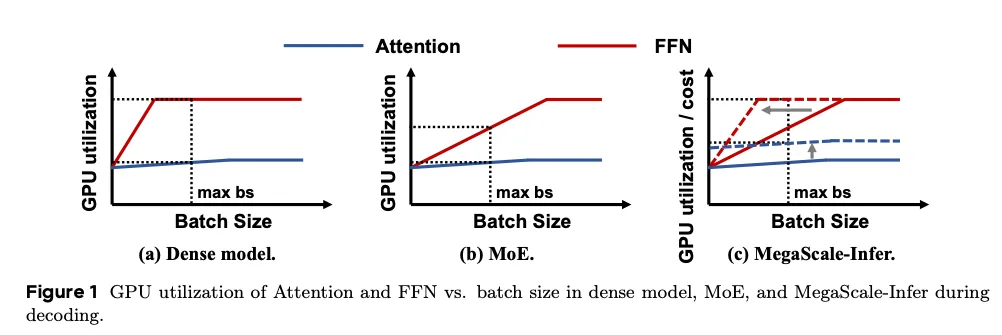
figure1 :decode attention 处于访存bound,kv读取量随batch增加,因而较难提升算力利用率。
论文聚焦 Decode 阶段的专家计算效率。稀疏路由将总 batch 分散给多个专家,使单个专家获得的 token 太少,权重读取成本难以摊薄。 增大 batch 可以改善这一问题,却同时增加 Attention 侧的 KV 容量、读取量与执行时间,受到显存和延迟预算限制。
由此产生 AF 分离的机会:将多个 Attention 实例的 token 汇聚给一个专家实例,让专家获得更大的有效 batch,同时将 KV 负担分散到 Attention 实例上。
Method
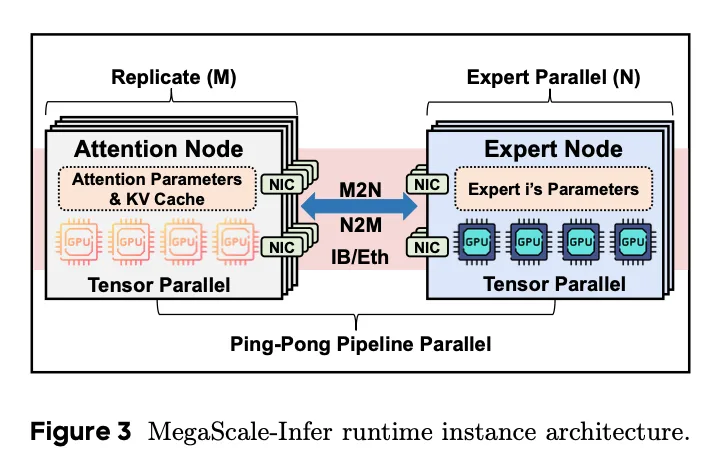
1. 分离式部署
Attention 与专家部署到不同 GPU;分别选择并行方式、规模和硬件,跨 Attention 实例聚合专家输入。MegaScale采用的是节点内 TP,AF分离只在节点间的方式。
2. 流水线调度
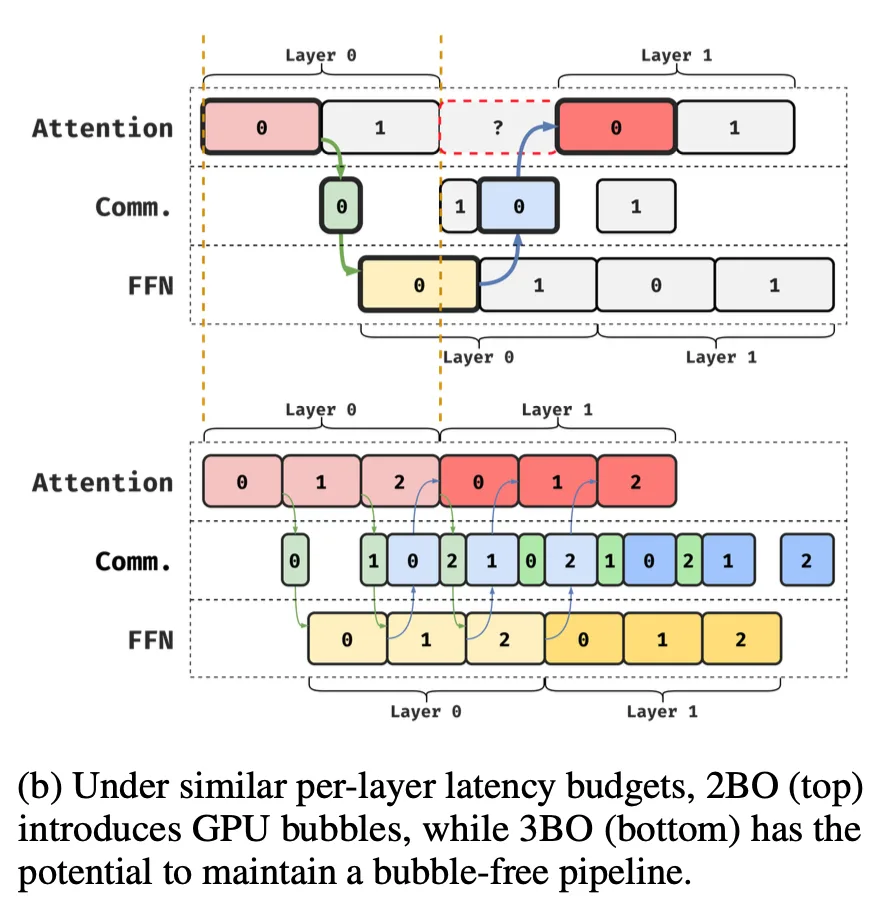
多个 micro-batch 在两侧交替执行,重叠计算与通信;搜索配置以平衡两侧耗时
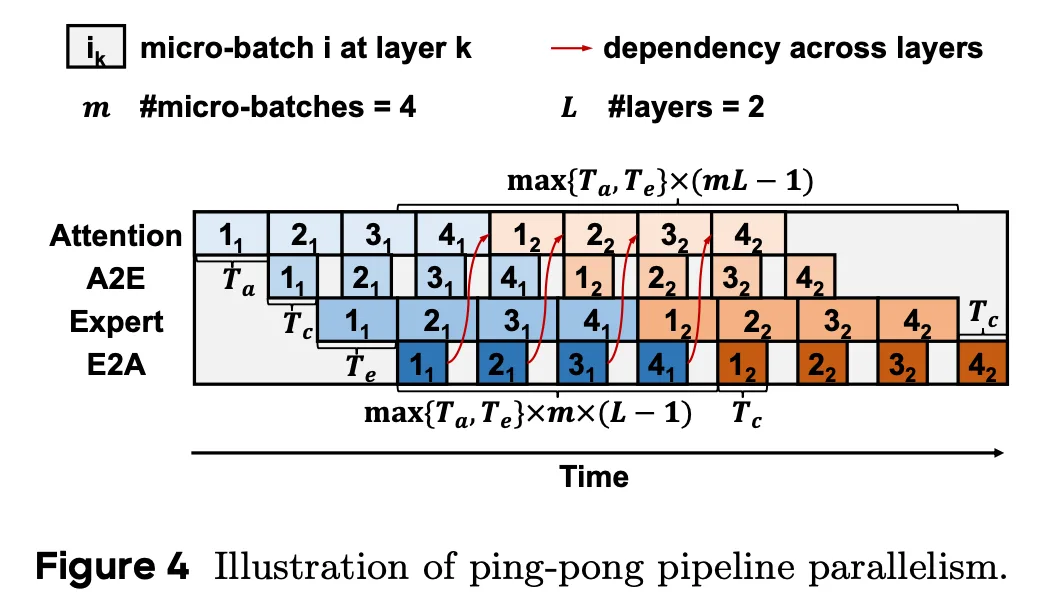
这个图使用了4 batch overlap, 实际上没有那么理想。流水线的气泡率实际取决于各阶段的负载,往往2bo(传统ep,不做afd)和3bo (afd)是常用的配置。
3. M2N 通信库
A/F 分离后,两侧 GPU 数量可以不同。每一层,A 侧需要根据专家路由,把 token 的激活发送到对应的 F 侧;专家计算完成后,再把结果传回来。因此,我们需要支持 M 个发送方与 N 个接收方之间的数据交换,这就是这里的 M2N。它传输的是激活,KV cache 仍留在 Attention 侧。
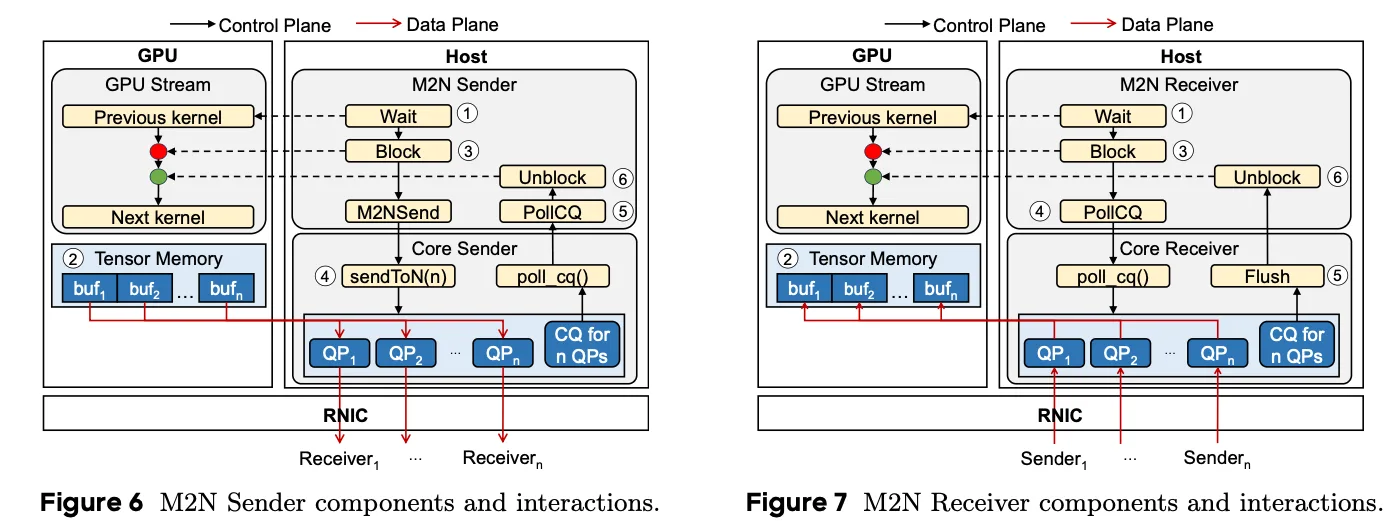
- QP:Queue Pair,由发送队列 SQ(Send Queue) 和接收队列 RQ(Receive Queue) 组成,用于提交 RDMA 通信工作请求。
- CQ:Completion Queue,保存工作请求的完成通知。图中的 PollCQ 就是轮询完成队列,检查通信操作是否完成。 一个 CQ 可以接收多个 QP 的完成通知,对应图中的 “CQ for n QPs”。
红线是数据路径:发送GPU显存-> 发送端RNIC-> 网络 -> 接收端RNIC -> 接收GPU显存。这里使用 GPUDirect RDMA,激活不需要先绕到 CPU 内存。
黑线用于控制数据依赖:发送数据算完了吗?传输过程中会不会被覆盖?接收方什么时候能开始使用新数据?
细节:以发送端为例
图中步骤 作用 ① Wait、② Tensor Memory 等前面的计算完成,待发送的激活已经写入预注册缓冲区 ③ Block 暂停该 stream 后续操作,保护正在发送的缓冲区 ④ Send CPU 提交通信请求,RNIC 从显存取数并发送 ⑤ PollCQ、⑥ Unblock 确认发送完成,放行后续操作,缓冲区可以安全复用
如何overlap? Block 约束的是图中这个 stream 的后续操作,不是把整个 GPU 停住。其他 micro-batch 的独立工作,在正确安排 stream、缓冲区和依赖之后,仍可以继续执行。
Main Result
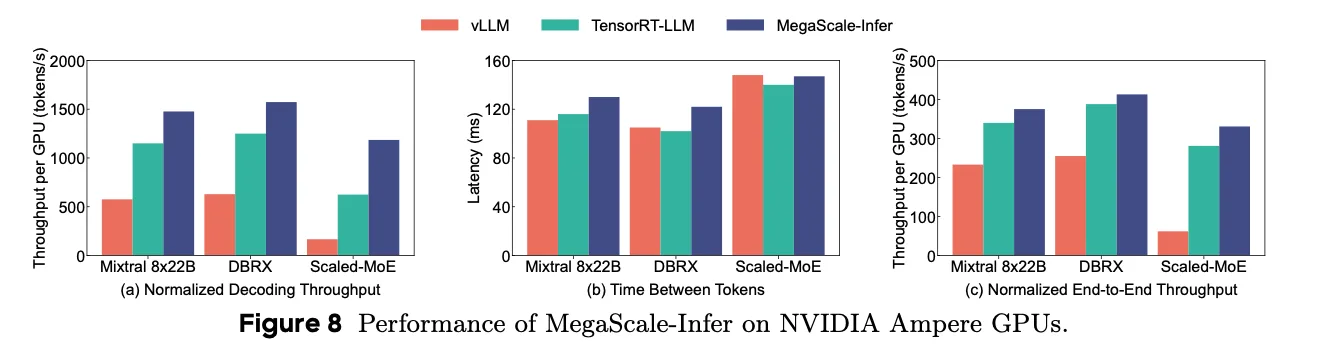
8x8 A卡,机内nvlink。结论:AFD 通过提高资源利用率,在满足延迟约束的前提下提升Decode阶段每张 GPU 的服务吞吐,而不是让单个请求生成 token 更快。
应用|Step-3:让模型结构适配AF分离
| StepFun Inc. 2025年7月 | https://arxiv.org/pdf/2507.19427 |
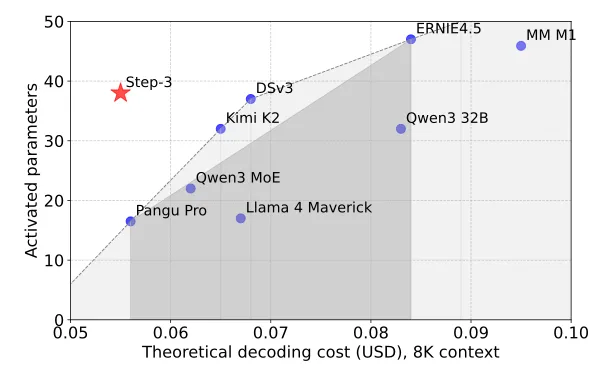
借助AFD等架构,Step-3 通过model–system co-design实现了更高激活参数量下的低成本计算。 它尝试回答:AF 分离提供了独立优化 Attention 和 FFN 的自由度,那么模型应该如何设计,才能真正利用这种自由度?
Method:Attn方案、MoE 稀疏度和AF分离执行系统
- Attn【此处不展开】:Step-3 使用 Multi-Matrix Factorization Attention(MFA)。通过低秩分解和共享 Key/Value,在维持注意力表达能力的同时压缩 KV,让attention匹配硬件的算力和显存带宽。
- MoE:根据硬件和网络能力约束 MoE 稀疏度。 诚然,F实例batch越大,计算效率越高。 但是 token 必须通过网络传入、传出,且通信必须满足逐 token 延迟预算。因此,存在一条关键约束:专家需要的 batch,必须是网络能够在延迟预算内送达的 batch。 Step-3 据此选择约 8% 的激活比例,包含共享专家。继续减少激活计算量,无法继续降低实际成本,因为硬件利用率也随之下降。
- 系统侧:仍然是分离部署+pipeline+通信库(stepmesh)三件套
Step-3 展示了通过模型与系统协同设计,在较严格slo下实现高效 AFD 的可能性。但如果模型结构已经固定,网络条件也无法自由选择,专家还能否获得足够的 batch?计算和通信又是否真的能够充分重叠?接下来的工作将进一步量化这些前提。
收益边界|MoE效率提升,如何转化为端到端收益?
通信带宽的影响|Revealing the Challenges of Attention-FFN Disaggregation for Modern MoE Models and Hardware Systems
| 百度百舸团队 2026年2月 | https://arxiv.org/pdf/2602.09721v1 |
核心质疑:AFD 希望通过聚合 attention 输出的 token,来提高每个专家的 batch,这些 token 必须先通过网络送到 FFN。但网络供给受限时,即便专家 GEMM 变得更高效,GPU 也可能只是更早算完,然后继续等待。
理论上,F实例增加能提高MoE计算效率
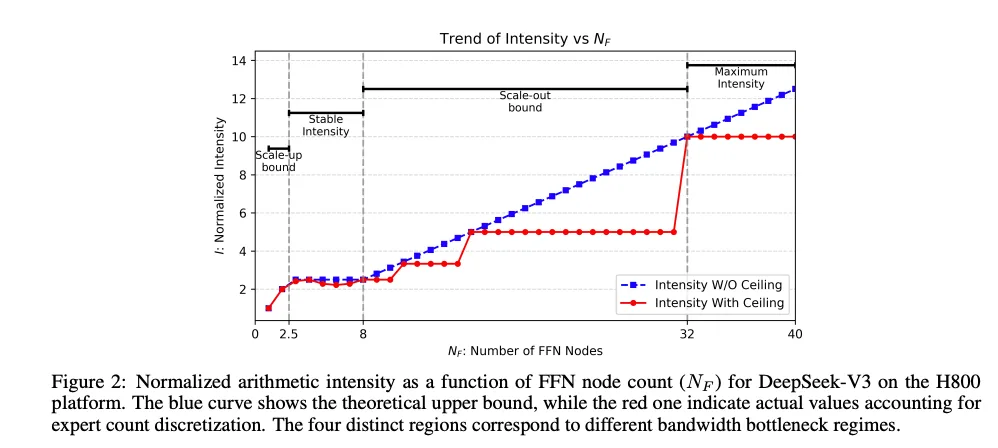
网络决定了每实例GPU能够输入的token上限,而计算强度 正比于 每张GPU的输入token数 / 每张GPU的专家数。
| 阶段 | 哪个带宽限制输入? | 增加F节点后发生什么? | 算术强度 |
|---|---|---|---|
| ① 机内受限 | NVLink 先满,机间带宽尚有余量 | 每卡输入的token数不变,持有的专家变少 | 上升 |
| ② 第一个平台 | 机间带宽满,NVLink 不再是瓶颈 | 机内复用命中减少,每卡输入和专家数同比下降 | 不变 |
| ③ 再次上升 | 机间带宽满 | 机内复用已降至约 1,每卡输入不再下降,但专家继续变少 | 上升 |
| ④ 最终平台 | 机间带宽满 | 每卡输入不变,专家数也不能再少于 1 | 不变 |
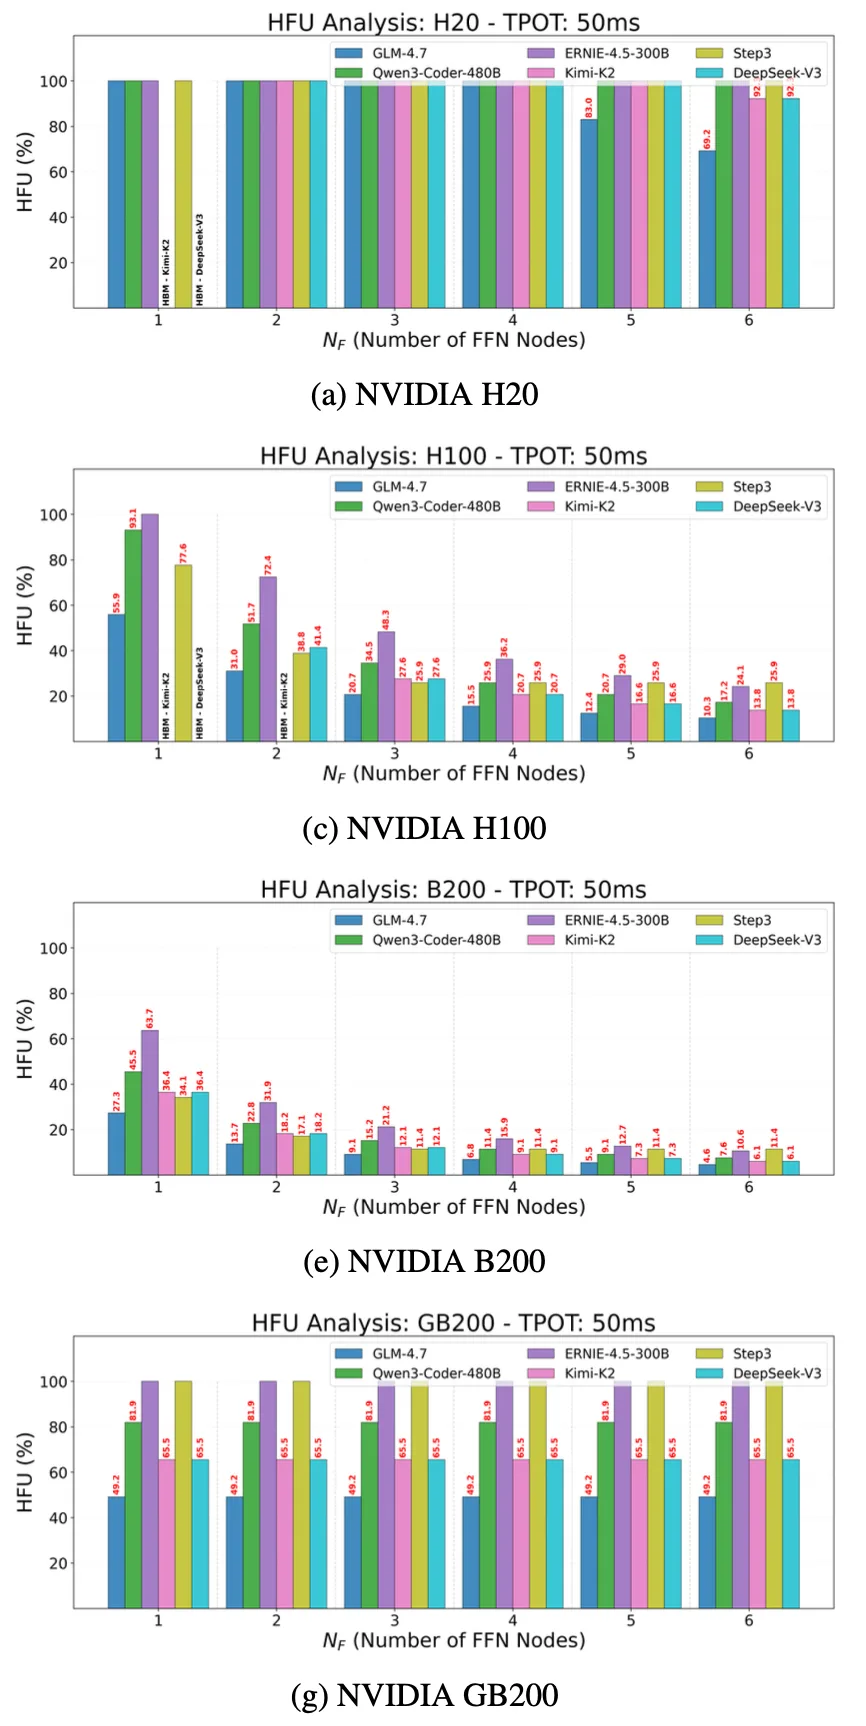
【上图】不同卡型上的AFD部署:不同的F实例数量下,纵轴FFN的理论HFU上限。(flops效率 x 计算时间占总预算的比例)。以 DeepSeek-V3为例,按公式复算:H20 100%、H100 41.4%、B200 18.2%、GB200 65.5%。
4张图的主要差别在于“算力能否被通信喂饱”:H20 算力峰值较低,容易达到高比例;H100/B200 算力大幅增加,但图中采用的跨节点带宽仍是 50 GB/s;GB200 则按 Superpod 高速互连建模。
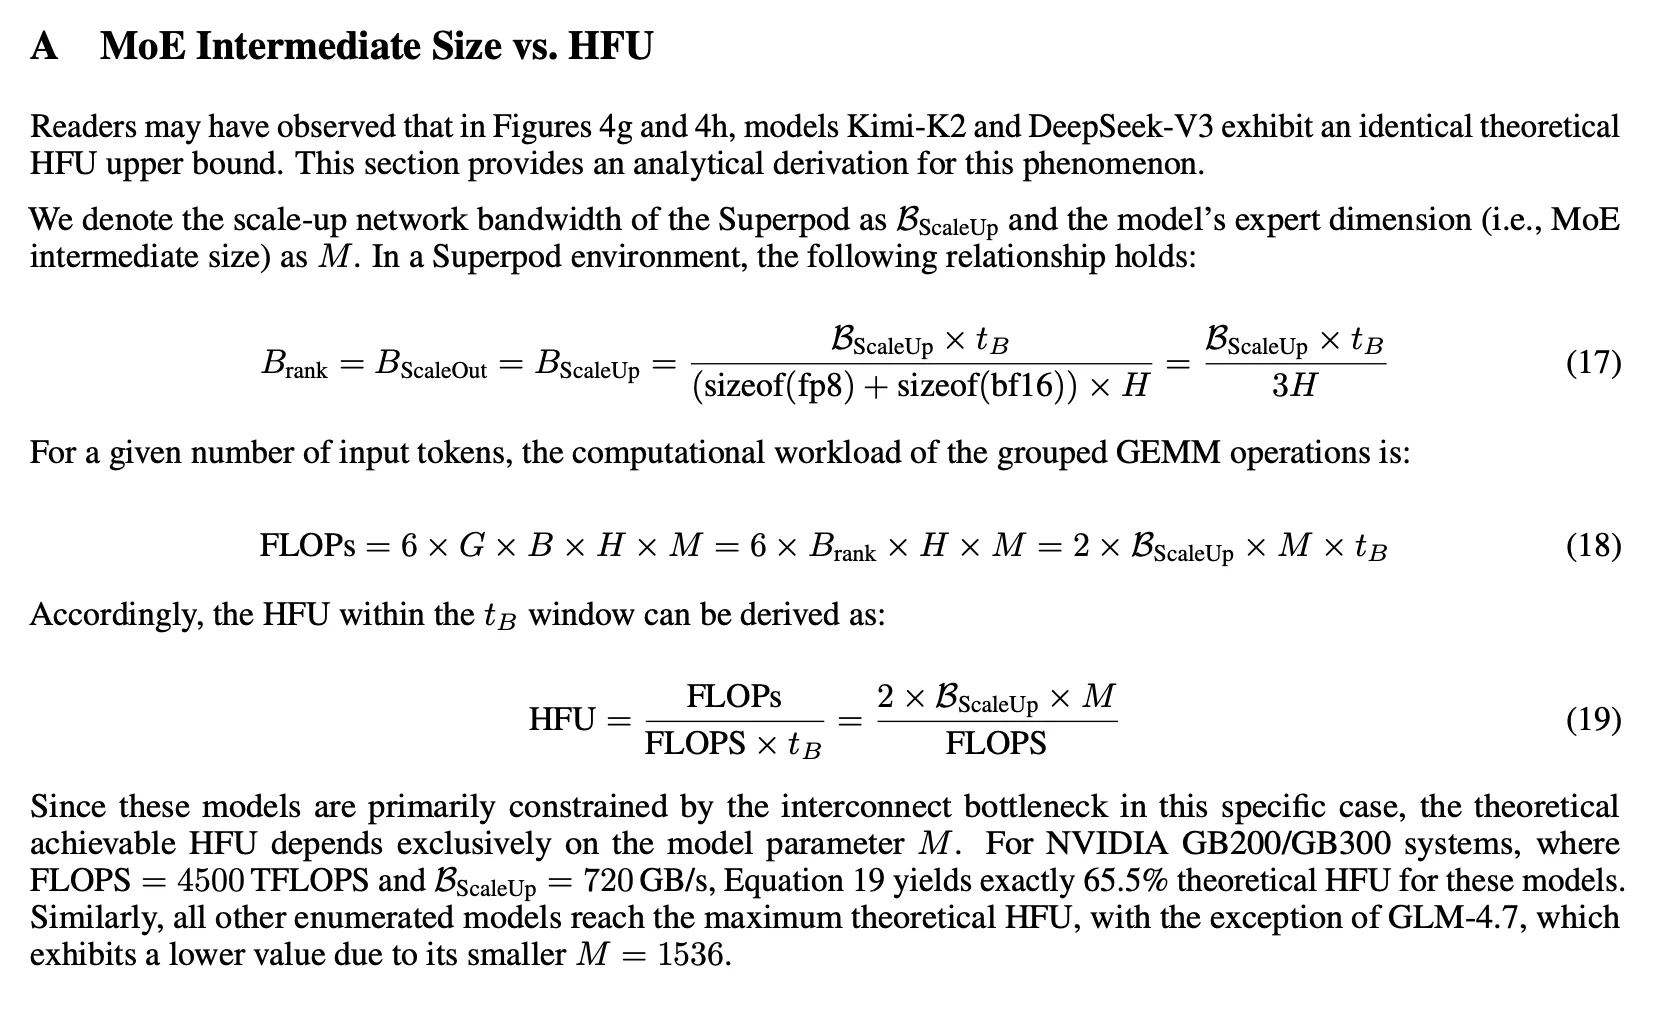
问题:为什么GB200的的HFU能够达到100%? 这里的 HFU 表达的是理想条件下、受通信供给约束的 GEMM 算力利用率上限,而不是通常根据实际计算量和实测耗时得到的 HFU。特定模型的专家中间维度较大,每字节通信对应更多计算;按 GB200 的 720 GB/s 互连带宽估算,可供给约 7.37 PFLOPS 的工作量,超过单 GPU 的 4.5 PFLOPS 峰值,因此理论上限被截在 100%。 HFU是经典的hfu,但是分子的flops是通信带宽用满的理想状态,论文在附录中也为眼尖的读者给出了说明:
分离架构的选择|How Far Can Disaggregation Go? A Design-Space Exploration of Attention–FFN Disaggregation for Efficient MoE LLM Serving
| Georgia Institute of Technology, Google DeepMind 2026年5月 | https://arxiv.org/pdf/2605.28302v1 |
核心问题:给定一批 GPU 和SLO,应该采用同机部署、PD 分离,还是进一步做 AF分离?分得越细,是否就越划算?
论文提出 AIC++,把部署选择统一成一个设计空间搜索问题。它接收模型结构、工作负载、GPU 集群和 SLO,考虑算子效率、通信带宽、显存约束,搜索各种配置的性能。
-
AFD能够用于prefill吗? 可以,但是AFD 在 prefill 和 decode 上的收益来源不同。Decode AFD 常用于汇聚多个 attn 的 token,提高专家 GEMM 效率;
Prefill 本身已经有大量 token,FFN 通常不缺 batch,因此AFD的价值在于 1. 分开配置AF资源,attn主导prefill,需要更多计算资源 2. 拆分显存占用,将attn kv cache和moe weight 拆分放置。
-
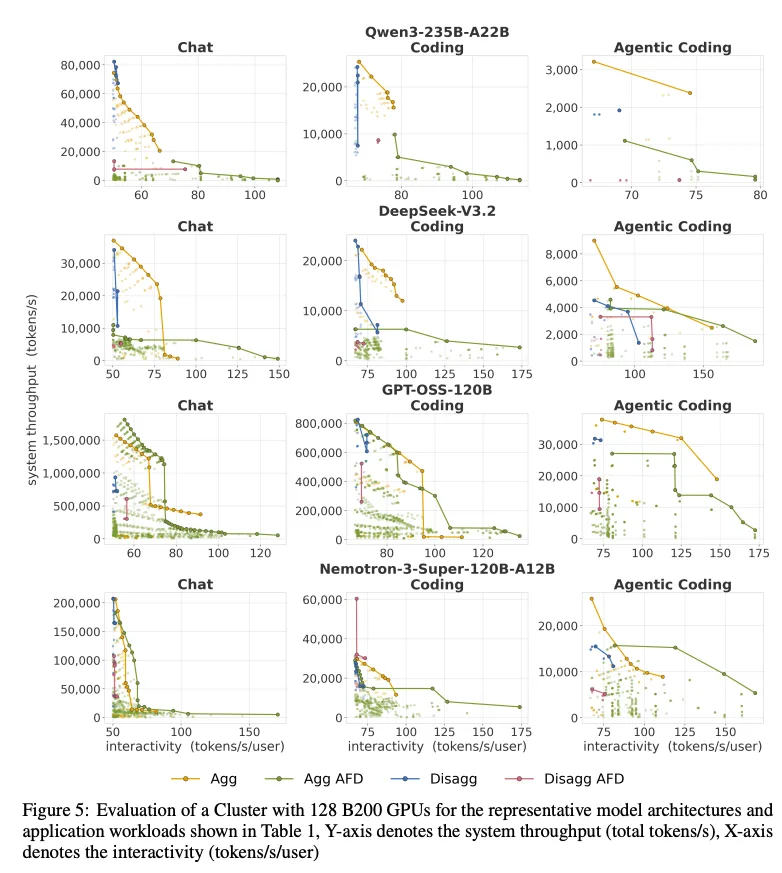
128xB200 下的模拟结果
| 优化目标 | 论文观察 |
|---|---|
| 最大化系统总吞吐 | 带 chunked prefill 的同机部署在多数场景占优,因为它能部署更多独立的 8-GPU replica,以数据并行提高集群并发 |
| 最大化单用户交互速度 | AFD 取得最靠右的 Pareto 点,即更高的 tokens/s/user |
| 确定 A/F 比例 | 需要按 Attention 类型、FFN 开销、上下文长度、KV cache 和 SLO 搜索,没有固定比例 |
注意此图是资源配比tradeoff, 并非固定slo下的优化问题。
AFD+PD共享|ExpertPlex: A High-Goodput Disaggregated Serving System for MoE LLMs with Adaptive Persistent Kernels
| 北京大学 2026年7月 | https://arxiv.org/pdf/2607.18002 |
动机和挑战
Motivation:MegaScale等讨论通常建立在 PD 分离之上。这样 prefill 和 decode 往往各自保留专家权重与计算资源:某一侧暂时空闲,另一侧也不能直接利用它。 Idea:ExpertPlex 让PD节点共享专家节点池。这可以减少专家权重的副本数,大幅减少权重显存占比,并让两个阶段利用彼此暂时空闲的专家计算资源。
挑战:共享会重新引入 PD 干扰:长 prefill GEMM 正在执行时,短而紧急的 decode 怎么及时获得计算?
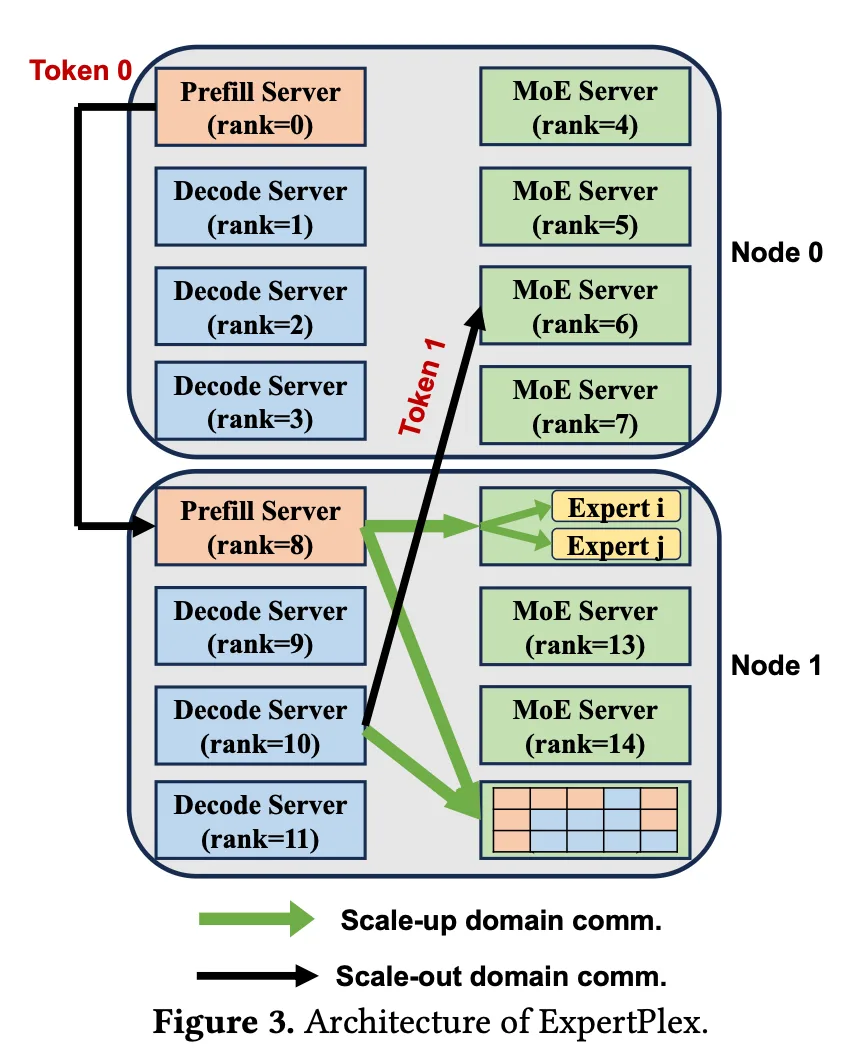
问题:为什么Prefill和Decode的分发路径不同? Prefill和Decode都是逐token的分发,prefill(token0)走分层(prefill server 跨机+机内nvlink),decode则直接走(rdma跨机 / nvlink机内)。核心考量是:避免Prefill 直接占用目标 MoE Server 的跨节点 RDMA 收发路径,把这些直接路径主要留给延迟敏感的 Decode。 如果目标节点没有prefill server,仍然会退回rdma直达。至于此处两个prefill server的并行方式,论文没有明确说明,但应该是dp replica。
ExpertPlex的核心方法是 Adaptive Persistent Kernel(APK):在 GPU 上运行persistent kernel,把专家计算拆成许多可调度、可独立完成的 tile,只在 tile结束的边界决定下一个tile属于prefill还是decode。 例如,prefill 正在执行一个很长的 GEMM,decode 到来后,可以在安全的 tile 边界交出部分计算资源;decode 完成或等待通信时,prefill 再利用空闲资源。无需等整个 prefill kernel 结束。
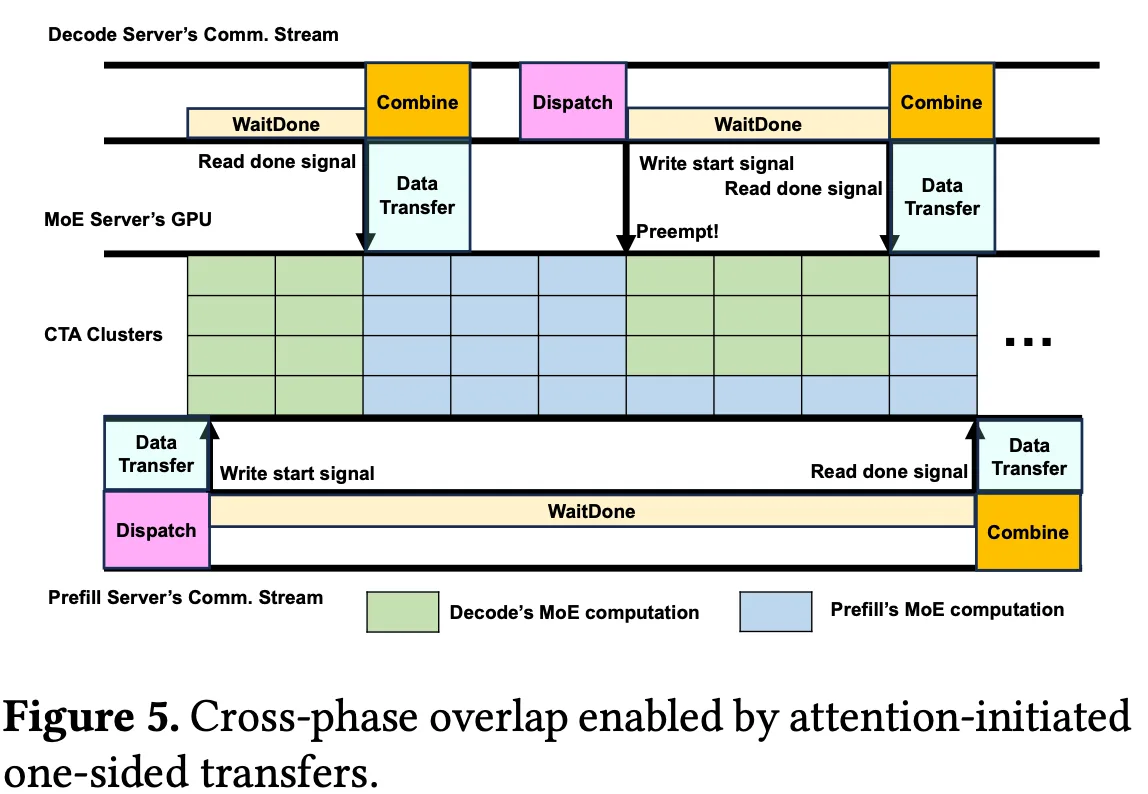
细节:APK的调度单位实际是 CTA cluster。一个 cluster 包含若干协作 CTA,占用若干 SM。APK同时动态支持两种共享方式:
- 空间复用:一部分 cluster 执行 decode,剩余 cluster 继续执行 prefill。
- 时间复用:同一个 cluster 完成当前 tile 后,可以从 prefill 切换到 decode,decode 完成后再回来。
实验结果:实验最多使用 24 张 H800,基线包括SGLang各种可行的PD配置,数据集包括短请求和长请求。这里 goodput 衡量满足 TTFT、TPOT 要求的服务能力。
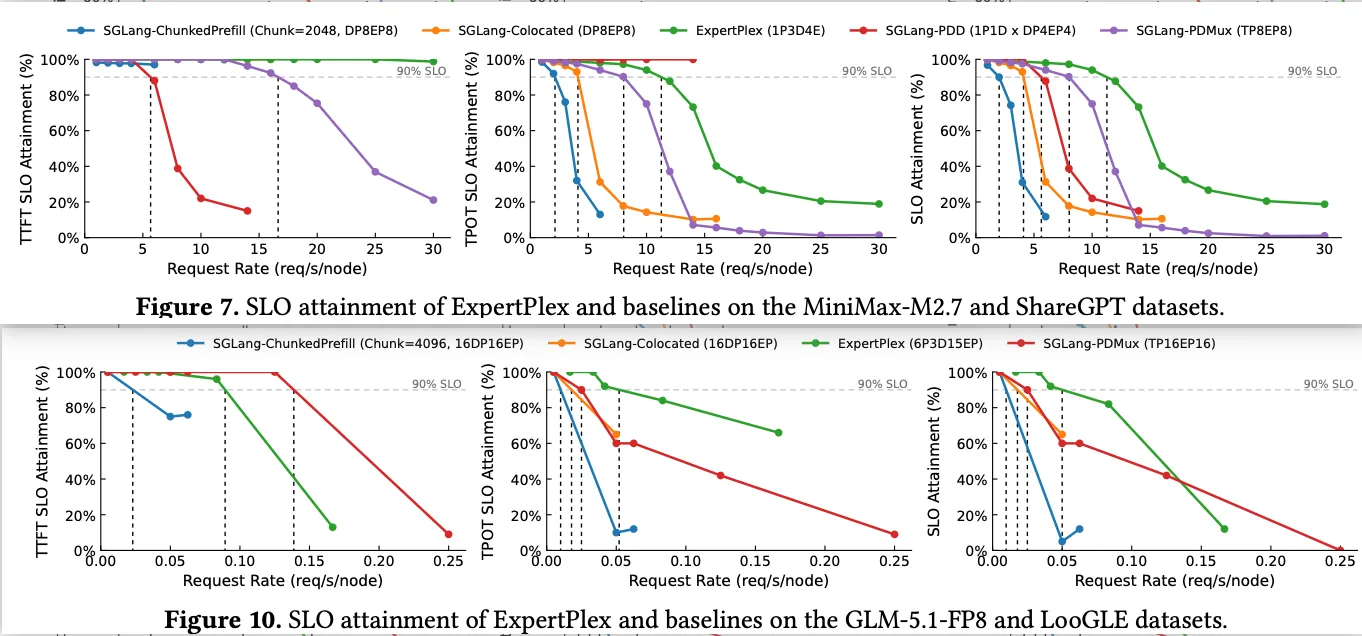
ExpertPlex未必在每一个单项上最优:
- Colocated偏向TTFT;
- PDD偏向保护TPOT;
- ExpertPlex追求两个SLO同时成立。
它通过独立Attention GPU、共享专家池和APK动态SM调度,在Prefill与Decode之间取得更好的资源平衡,所以右图中90%交点最靠右。
AFD+动态负载均衡|AFORE: Attention-FFN Disaggregation with Overlapped Reconfiguration of Experts
| 港科大 2026年10月 | https://arxiv.org/pdf/2610.03203 |
此工作在AFD的基础上,考虑了热点专家负载均衡问题。 AFD 把 FFN 变成独立阶段后,一张 GPU 上的热门专家可能拖慢整个阶段。AFORE 重点讨论了:依据什么需求调整专家权重,以及怎样避免搬权重的开销抵消收益。
核心洞察是,AFORE利用了 AFD 的一个时间窗口:
目标 micro-batch 在 A 侧完成路由时,我们已经知道它需要哪些专家;但 F 侧可能还在处理前面的 micro-batch。
于是可以执行以下流水线:
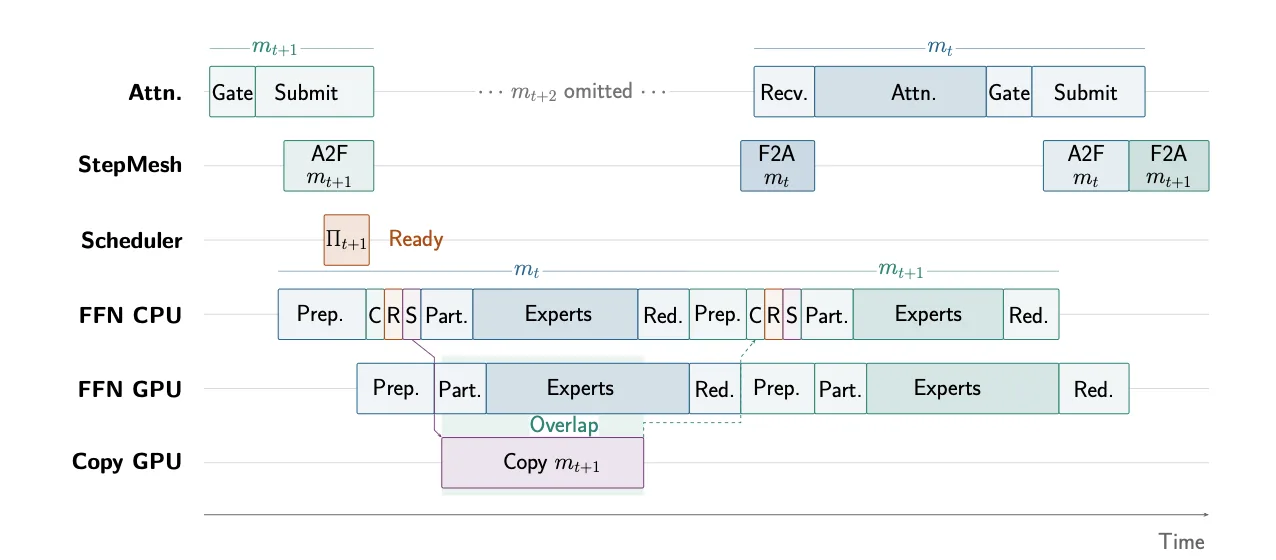
这里“提前知道”指的是已经完成路由、尚未执行 FFN 的批次,不是预测未来尚未生成的 token。
论文在 16 张 A100、GLM-4.5-Air 上,相对各负载的最强基线报告 10.1%–17.6% 的吞吐提升。迁移测量中,平均复制约 0.45–0.50 ms,可用窗口约 2 ms;但窗口缩短时,迁移未必能完全隐藏,论文也并没有考虑2bo/3bo下的通信带宽余量。