救救顶会
那种事情不要啊😭
今天听闻了ICLR27投稿数超过历史总和的消息。作为作者和审稿人,对ai顶会的投稿积弊感到强烈的悲哀,当年我们的白月光,那些可望而不可即的,朝思暮想辗转反侧的顶级会议,如今竟已沦为人尽可夫之物……
早在去年底pacman年会时,我就预见了ai加速下审稿系统会面临劣币驱逐良币的问题,并开始转向开源仓库的构建。如今完全应验,让我一不愿意投稿,二不愿意审稿。
整个2026年至今我都没有写一篇新的论文。当然我也拥抱ai做出了很多有意思的工作,但我完全没有将它们转化为论文的想法。因为,
- 在我完全理解并确认理论有效前,我不会将它公开,这无异于灌水;
- 我并不愿意和“6w篇sota”放在一个池子里比较,这无异于在化粪池畅游。
- 绝大部份的review是不负责任且无营养的。
ICLR给出了20篇限投令,旨在减轻审稿负担。但在我看来,这完全是一刀切的治标不治本方案,限投令能够解决“大老板”们无脑挂名的问题,解决不了“小作坊”无脑灌粪的问题。
投稿暴增之原因,在于:
- 论文产出的成本很低。
- 审稿的质量很低,无法低成本鉴别论文好坏。
最终必然导致“抽奖”。
我并不直接反对ai辅助投稿,我反对的其背后的AI产出idea,自动生成实现,对结果不负责的灌水行为。我不相信AI产生的idea能够无痛转化为真实而solid的sota提升。大部分速成论文的优化结果,都是通过:
- 削弱甚至伪造baseline
- 虚构场景和负载
- 甚至直接修改结果
产出的。而现有的审稿机制,没有办法验证这件事情,中稿后被打假的可能性也约等于0 。审稿改革的当务之急,是解决这部分可称为学术不端的论文。
我尝试给出解决方案:关键在于复现(Evaluation)。
AI能进入并包装、加速一切环节,除了唯一一项:实验运行过程。
人类能伪造、润色一切论文内容,除了唯一一项:真实实验结果。
这也是最直接可以验证工作价值的指标(significance),仅凭“是否sota提升”,我相信足以刷掉90%的论文。当然有很多有价值的工作,不在提升sota,但是所有论文都有实验部分,因此以实验作为投稿门槛依然能有效筛选。如何实操?我想了三种方案。
首先强调一点:保证论文结果可复现,不是审稿人的责任,而是作者的责任,是基于学术诚信许下的承诺。审稿人没有义务去准备资源、配环境和跑实验。而且,我并不认可大部分审稿人具备当今时代的审稿资质。因此下面的解决方案,都是由作者+会议方(的AI)而不是审稿人去完成。验证所需要的开销,以投稿费的形式向作者收取,收费形式参考注册费。
一、第三方验证和复现
借鉴ACM系统顶会(SC、EuroSys、OSDI等)的AE (Artifact Evaluation) 机制:
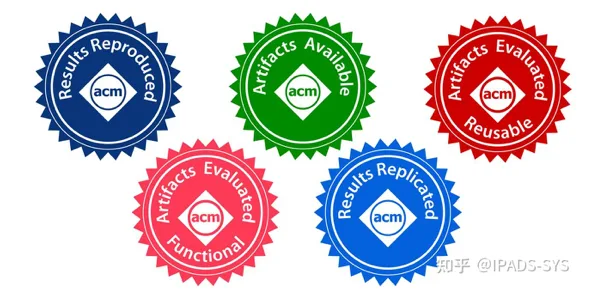
AE 的评估标准被分解为三个递进的 ACM 徽章,这为验证提供了可操作的粒度:
· Artifacts Available(可获取):最低门槛。制品在永久公共仓库中可获得,并配有 DOI。不强制要求能运行。· Artifacts Evaluated – Functional(功能完备):中等门槛。制品完整、文档齐全、能按描述运行。评估员会检查文档质量、组件完整性和可执行性。· Results Reproduced(可复现):最高门槛。评估员独立运行实验,并确认主要结果在允许的误差范围内得到重现。这不要求结果完全一致,关键是核心主张得到独立验证。
为了复现,需要一套直连论文工作区的镜像,并有相关鉴权和控制协议,从而保障信息安全。作者需要尽量提供可一键运行至结果报告产出的脚本,并开放对应监控借口,允许顶会官方的AI进行运行时监控。但是,很多论文的实验需要很多天,硬件资源也并非一直开放,重新验证的成本非常高。
对于这种情况,作者可以提供核心代码,为了避免审稿人洗稿的可能,此代码不对审稿人可见,由官方ai进行粗审核,鉴别代码是否与论文所述一致,“提供匿名的核心代码”可以作为投稿门槛。此门槛能够有效解决“假开源”问题。对于需要闭源的工作,则放入另一个赛道,此处按下不表。
二、实验日志机制
借鉴币圈的区块链机制,在交易的过程层打标记,防止篡改,从数据层面保证:实验确实被做过而且得到了正确的结果(ai唯一无法包装的),且不增加额外的工作和开销。
需要一套完整的自动记录协议,可以每个会议以插件形式提供(参考大厂的安全插件),用户无感知:
实验过程中自动记录:代码 commit、数据哈希、环境、超参数等。每条日志包含前一条的哈希,形成本地哈希链。每隔一段时间或每个实验阶段,将当前根哈希锚定到OpenReview区块链或 OpenTimestamps。投稿时提交根哈希和锚定交易 ID;评审方只验证链是否完整、确认总工作周期和工作量。
这种机制的缺陷在于区块链只能保证过程真实。如果从头开始造假,则无法被验证。但也已经大大提高了灌水门槛。
三、同期投稿交叉验证
将同一投稿周期内的6w篇文章,一定有相同赛道和相同优化目标的,可以纳入统一比较框架,用相对排名替代孤立评分(超参和实验策略需要完整披露)。同一赛道内,要求所有论文必须报告至少一个公共基线(由会议指定)。
这个方法不是在卷榜单:因为条条大路通罗马,能带来效果的方法都欢迎——核心在于统一baseline。AI也许无法单独判定一篇文章/实现的正确性,但多个工作横向对比,很容易检查出下面的异常:
- baseline被削弱:同赛道其他论文在同一基线上报告了更高指标,而该论文的baseline指标显著偏低。
- 负载伪造:声称“训练了1000 GPU小时”,但同赛道同等规模实验的合理时间/算力远低于此。
- 调参伪装成创新:同赛道多篇论文做了超参搜索,只有你的“方法”提升显著但baseline没调参。
先写到这里。我认为学术圈是我们共同构建的,如今这种虚假的繁荣,最终只会阻碍科技的进步。我这些拍脑袋的想法仍有很多没考虑到的地方,只希望能抛砖引玉,形成一种也许可行的,挽救顶会的方案。