针对某篇论文的发泄
有些人已经不是在灌水,而是在投毒。这完全触碰我的底线了。
最近在尝试把FlexCache写成技术报告,然后准备找个好的下家把她嫁了——没有了孤导的帮助,我没空也没能力设计好的Diffusion Cache算法。目前找的是MLSys,它没有ccf的混沌赐福,应该比较干净一点,而且时间合适,也适合co-design的工作。
考虑到审稿阶段必然面对的AI审查人,我准备见人说人话,见鬼说鬼话:技术报告以数据为主,论文版本以故事为主,并推荐大家去看技术报告。
然后今天和ai合作写初稿的时候,一个熟悉的论文名字映入眼帘:
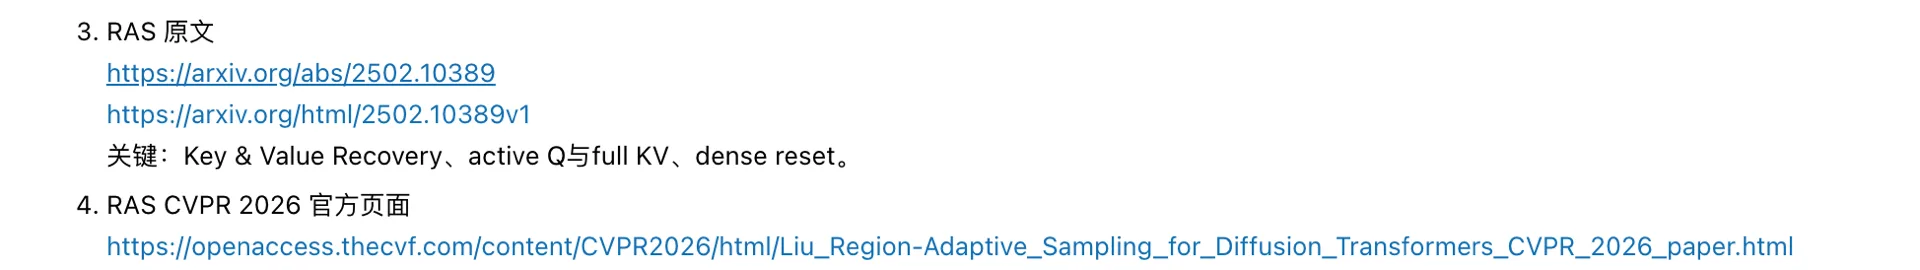
我懵了:啥?我缺乏和RAS的对照?这是CVPR2026的文章?
为什么我会这么惊讶,因为这篇文章恰好跟我的思路撞车了,而且它几乎囊括了所有我最讨厌的灌水行为。
跟RAS的爱恨情仇(其实只有恨和仇),从Jano投稿时(2025年11月)就开始了。当初的论文,80%还是手搓的。详见《舒服了》,当时密锣紧鼓投稿完成的第二天,我们发现了RAS这篇文章(arxiv),当时天都塌了——因为它虽然说自己是个sampler,但是其实是一个runtime和我们几乎完全相同的cache工作。
RAS的通讯还是我很尊敬的知乎顶流Yang You,在HPC圈子里也是有名的lab了,我相信他们肯定做得比我们草台班子好。
我的第一反应是撤稿。 因为我们没有在论文中讨论这个完全撞车的前序工作,还好孤导劝住我了,我们在万念俱灰下决定死马当活马医:在补充材料中添加比较Jano和RAS的实验。
冷静下来以后,我开始仔细阅读RAS的文章,希望找到我们比他们好的地方,并把它们的代码拉取下来实际跑一下。结果一跑吓一跳:复现的实验结果可以说拉完了。
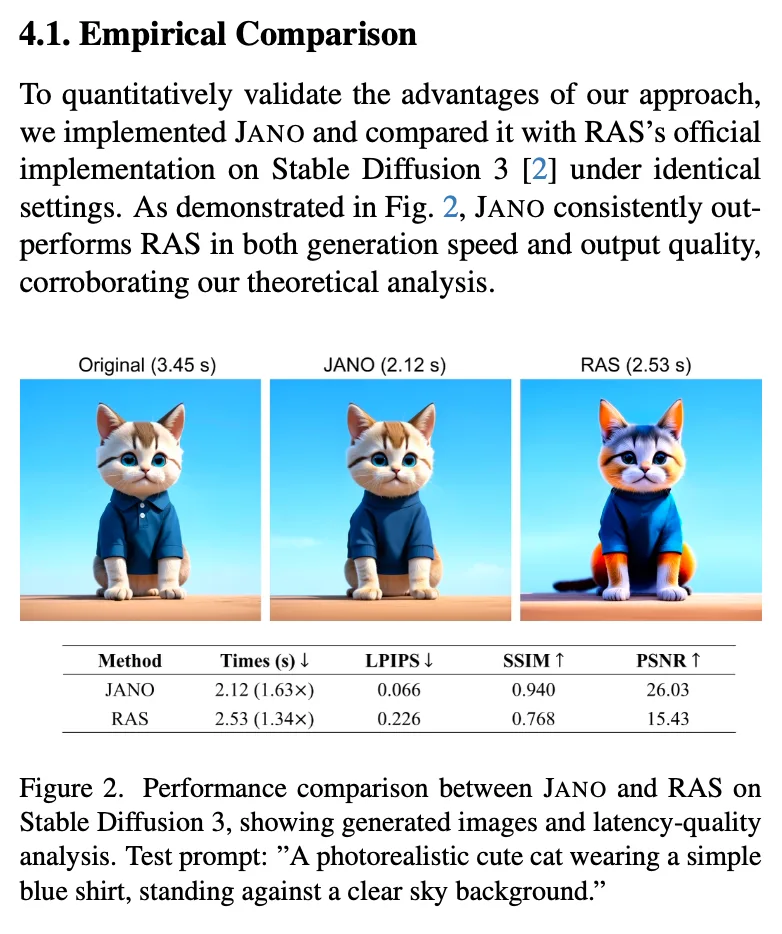
有多拉呢?达到一种你怀疑自己复现错了的级别(当时复现还是需要手动配环境准备权重的,不能ai一键复现)。我举个例子吧,RAS 50%的cache ratio,也就是2x的加速比,生成图的质量远低于我直接将inference step设置为原来的1/2(不做任何优化)。
仔细看他们自己的补充材料,竟然也有相同的结果!
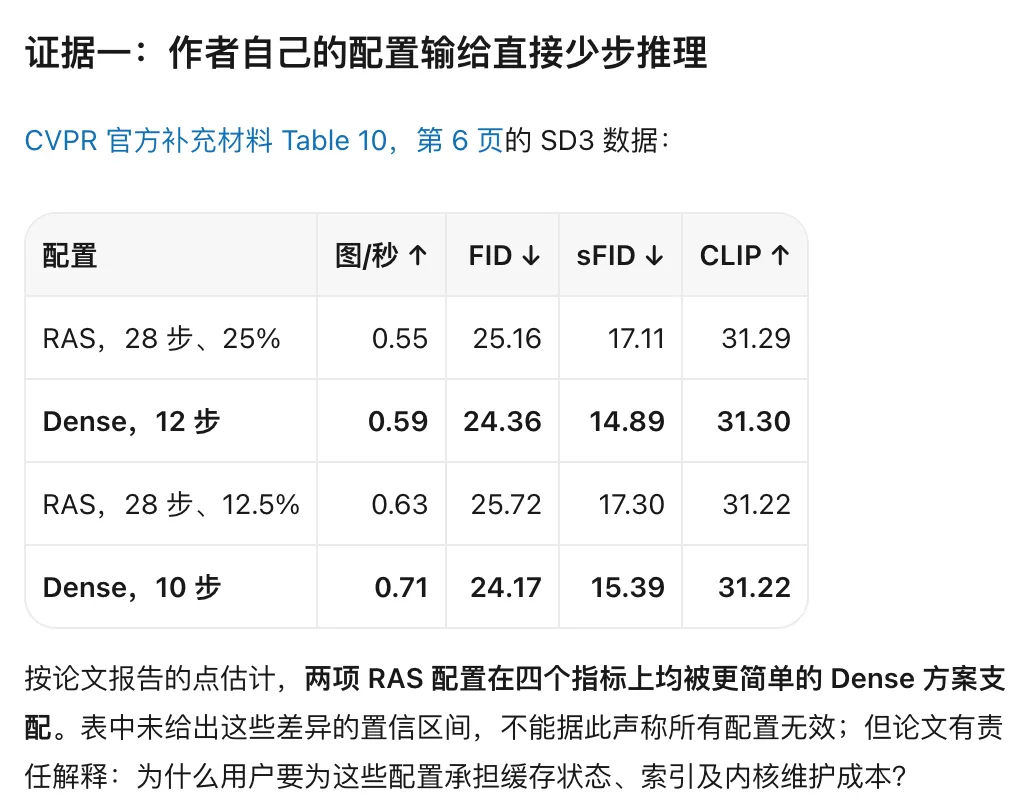
也就是说,他们的工作,完全是负优化!搞了一大通,把人家模型的原有能力完全破坏了!
当时我把这个结果写上补充材料的时候,我有一种 被粪水拖把袭击了 的感觉:哪怕打赢了,也是沾上了一身脏。我的文章这辈子都要和这种东西黏在一起了。
为什么这样的实验结果(完全不work),他们还敢端上来呢?他们要怎样讲这个故事,才能形成一种烟雾弹骗过审稿人的眼睛?我认为他们的方法是:他们说这是sampler,而不是cache。从而只和rectified flow这种sampler baseline 比较,而不和任意的cache工作比较。然后,把不利的结果放在补充材料里面,再以一种混乱的形式排布,让人没法一眼看出来到底在比什么:
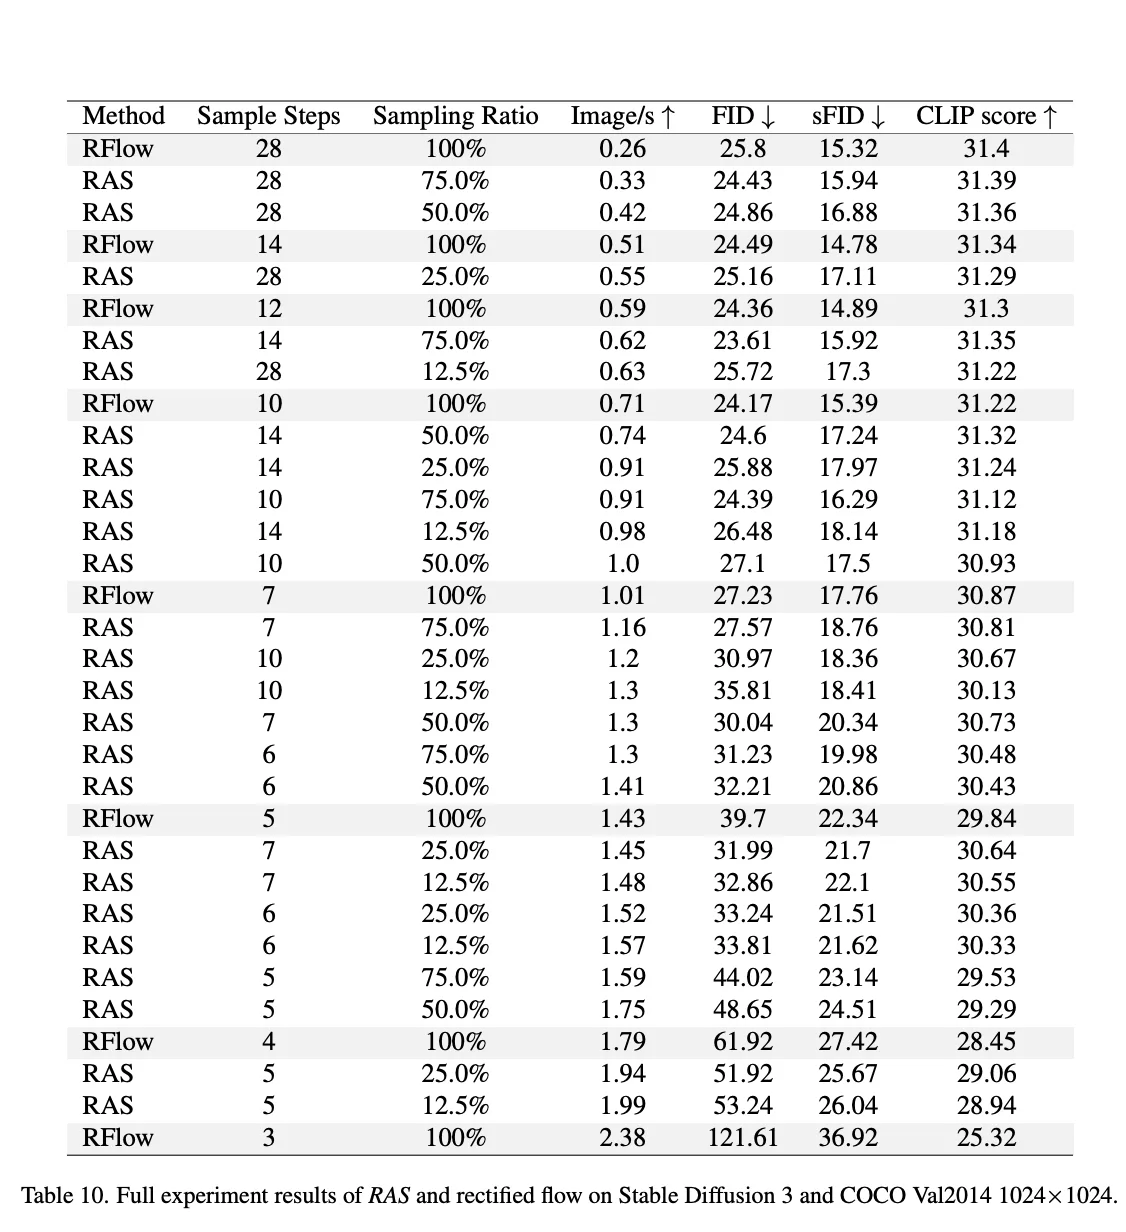
我说实话,不是Astra 6,我也看不出来这里是dense和ras的比较,而且dense结果远强于ras。
当然了,这是我个人的恶意揣测,作者也许只是不小心没有注意到这些数据的关系,肯定也是先想到sampler再开始设计工作的。
然后,我们找到了RAS在ICLR的openreview:
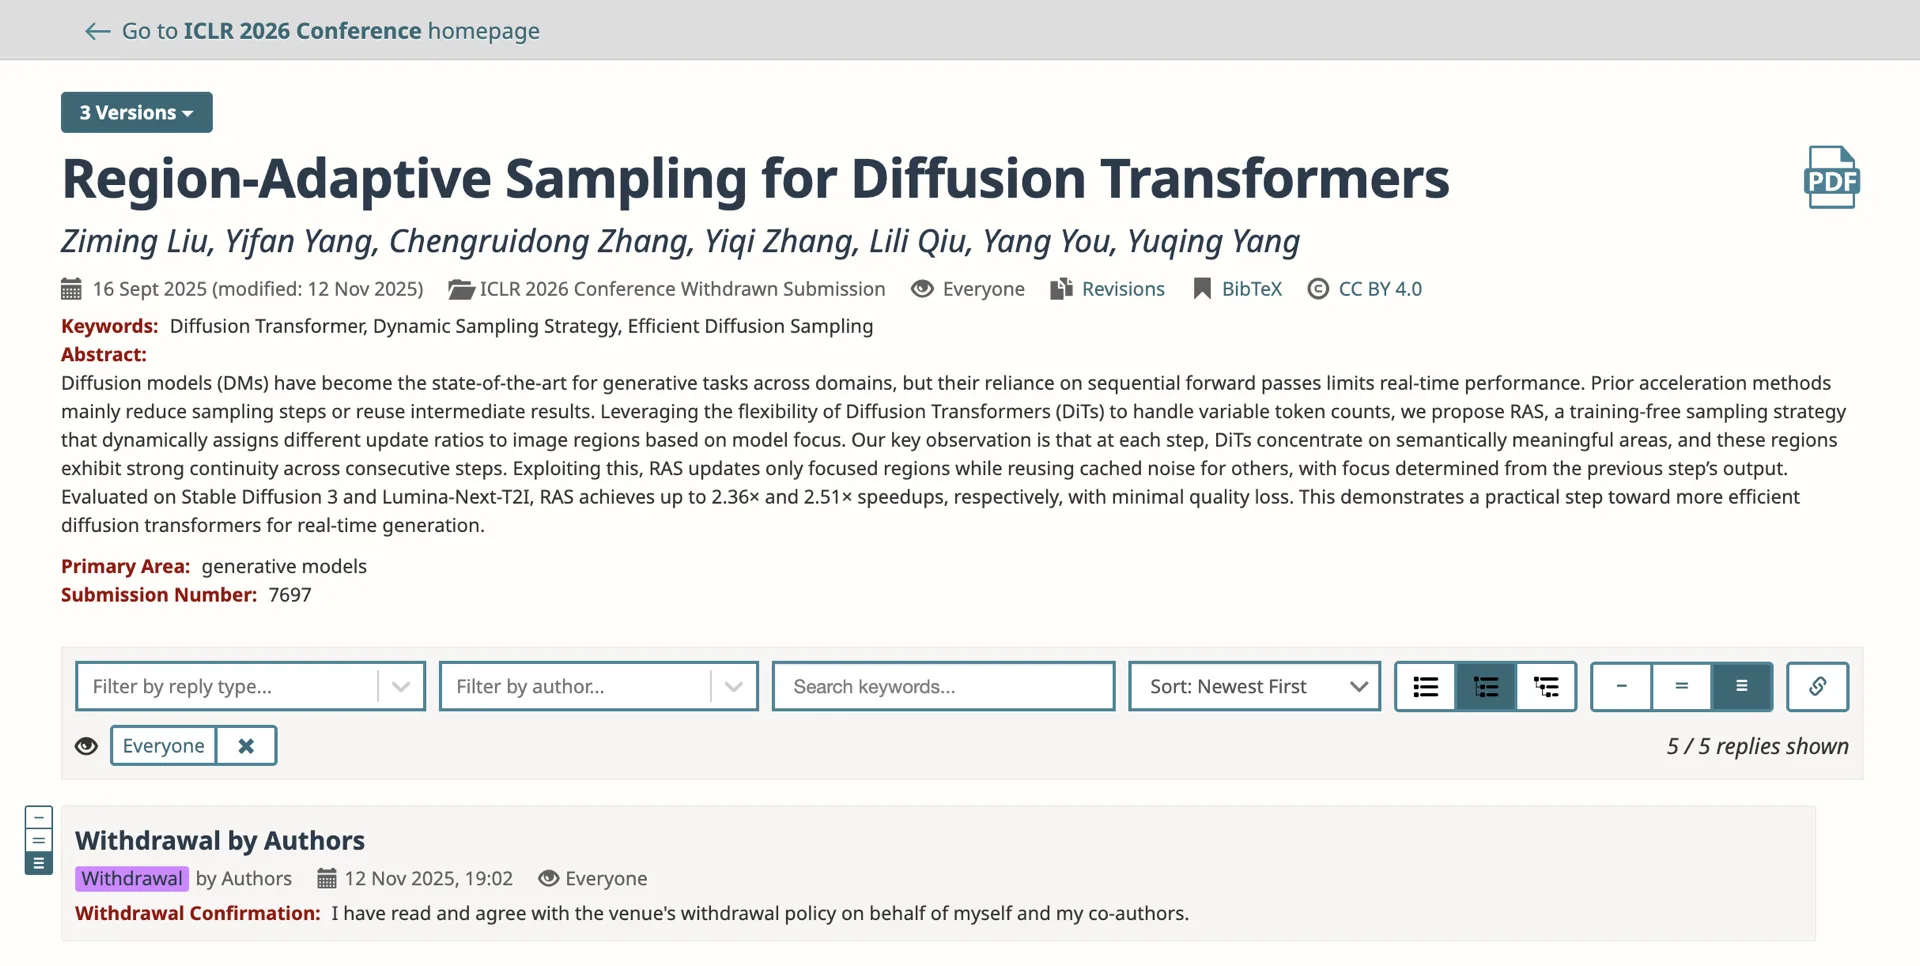
评分是4,2,2,6 (4,4,4,5),其实这里的巨大方差已经(审稿乱象)初现端倪了。还好两位2分审稿人看出来他结果的拉胯以及基线的缺失其中一位明确质疑:低步数 Dense 自身质量差,而较高步数时 RAS 的价值不足。他们秒撤稿,也是直接转向cvpr的抽奖了。
那么在2026年的cvpr正文里,他们增加了什么内容呢:
CVPR 终稿新增两项缓存(deepcache, delta-dit)对照,仍未回答完整pareto前沿与直接 token-wise 近邻的竞争力问题。
就用这种年纪都够当我爷爷的基线和负载去比较,无所谓,就是抽奖~ 抽中了就美美发布新闻,叫全世界都来品尝。
最早的 arXiv v1主文 Table 2 就突出有利的低步数对照,完整表已包含上述反例。CVPR 终稿仍以有利比较为主,将完整数字放在补充材料。一个宣称推进前沿的方法,应在正文交代自己在哪些预算上被最简单的对手击败。不能说是撤稿后才开始把反例移入附录——v1 已如此。
当然了,这只是我的情绪化表达,作者肯定只是没注意到/没想到还要这样比较而已。对不起对不起🙏。
我在《救救顶会》里为什么这么悲观,因为我觉得AI让大家浮躁了,有一点点结果就来灌水,避重就轻地包装和投稿,而且ai审稿往往也失能,最终导致顶会的抽奖。
但其实我自己也灌水,像flexcache我觉得也挺水的,我觉得,只要ai能够带来好的结果,就值得包装一下去让同行评审。在这个圈子混,没办法有这种学术洁癖,不要太离谱就睁一只眼闭一只眼算了,退一步海阔天空。
但我不能接受像RAS这种投毒行为。
若论文本身就不work,还为了中稿强行包装,去混淆视听,过度claim,将特定情况的加速写成普遍进步,却不清楚披露自己的弱点,后续研究者可能据此选错基线、重复移植和调参,并将薄弱前沿当成新方法的进步。这是可预见的研究资源浪费风险,而不是已统计证实的损失。
我相信这种情况其实挺普遍的,小红书上有很多挂别人文章的帖子。顶会文章大部分就是那么草台,金玉其外败絮其中,但没办法,我们还是需要顶会文章。
至于这篇,没办法,撞我枪口上了,而且在Jano投稿期间,给我和朋友带来了极大的精神损失。本来都忘了,今天还让它抽奖抽中了出来蹦跶,真的受不了了。
我已经在PubPeer上进行了理性的匿名评论并且email了一作,且看看他如何回应。